Faut-il encore bloquer les pages de recherche interne de son site à Google ? La consigne a disparu de la documentation officielle, mais Google continue de le recommander. John Mueller l’a expliqué dans le dernier épisode du podcast Search Off the Record, fin juillet 2026, avec deux raisons très concrètes : la charge serveur et un risque de spam qui peut faire passer votre site pour piraté.
Le sujet paraît technique. Il concerne pourtant quasiment tous les sites e-commerce et la plupart des sites WordPress, puisque tous ont un moteur de recherche interne. Voici ce qu’il faut retenir et les réglages que je vérifie lors de mes audits de consultant SEO.
C’est avant tout une question de budget crawl, que les erreurs 404 peuvent aussi entamer.
Que dit Google sur les pages de recherche interne ?
Google n’impose plus de bloquer les pages de résultats de recherche interne, mais il le conseille toujours pour des raisons techniques. La règle figurait dans les anciennes consignes pour webmasters depuis 2007, rangée parmi les contenus générés automatiquement et les « espaces infinis » d’URL. Elle n’apparaît plus dans les Google Search Essentials, qui les ont remplacées.
John Mueller a précisé que Google ne considère pas un site comme du spam parce que ses pages de recherche sont indexables. Le problème, selon lui, est surtout l’inefficacité : vous laissez Googlebot explorer une infinité de pages qui n’apportent rien.
Quels risques si vos pages de recherche sont indexables ?
Le risque principal est double : un gaspillage de ressources d’exploration et une exposition au spam qui peut déclencher un signalement « site piraté » dans la Search Console.
Une exploration gaspillée
Chaque requête tapée dans votre moteur interne peut générer une URL unique. Si Googlebot commence à les suivre, il passe du temps sur des pages sans valeur au lieu d’explorer vos fiches produits ou vos nouveaux contenus. Sur un gros catalogue, cela ralentit la prise en compte des mises à jour et charge inutilement le serveur.
Le piège du spam par la recherche interne
C’est le point le plus sérieux. Des personnes malveillantes peuvent créer des liens vers des URL de recherche de votre site contenant des termes de casino, de pharmacie ou à caractère adulte, parfois avec un numéro de téléphone. Si votre page de résultats affiche ces termes et reste indexable, votre site se retrouve avec des pages qui se positionnent sur des requêtes toxiques.
Personne n’a piraté votre serveur, votre site fait simplement ce qu’on lui demande. Mais pour Google, le résultat ressemble à un piratage, et la Search Console peut le signaler comme tel. Avec, à la clé, une perte de visibilité le temps de nettoyer.
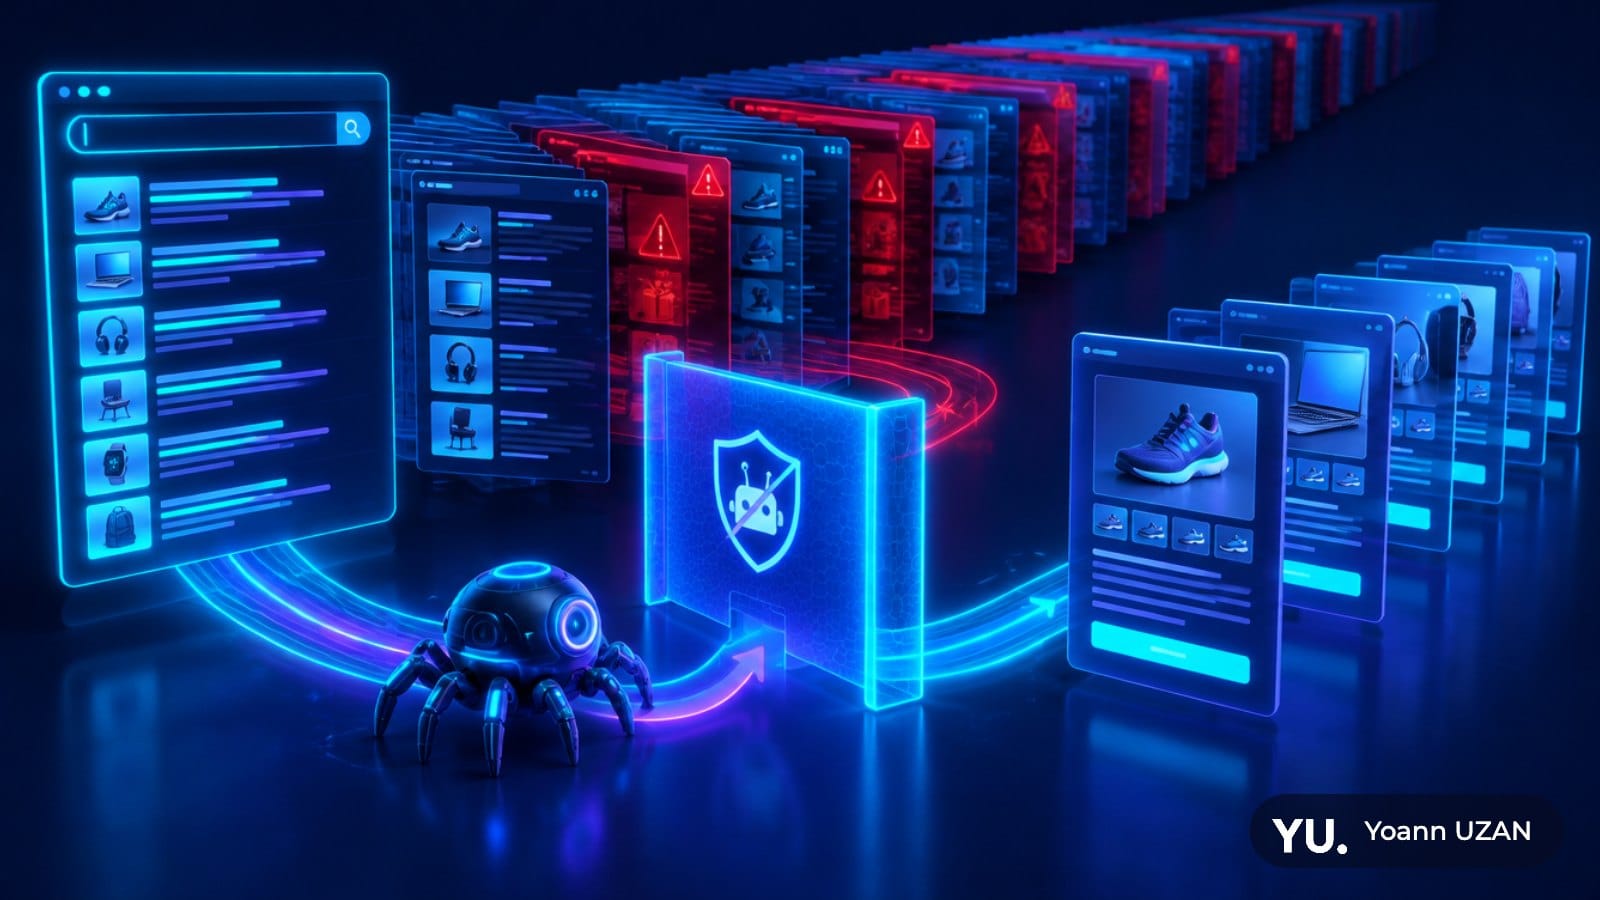
Comment bloquer correctement la recherche interne ?
La méthode la plus sûre combine une balise noindex sur les pages de résultats et, une fois ces pages sorties de l’index, une règle Disallow dans le fichier robots.txt. L’ordre compte : si vous bloquez l’exploration d’abord, Google ne peut plus voir la balise noindex et les URL déjà indexées peuvent y rester.
- Identifiez le format de vos URL de recherche : paramètre ?s= sous WordPress, répertoire /search ou /recherche sur la plupart des solutions e-commerce.
- Vérifiez dans Google avec l’opérateur site: et dans la Search Console (rapport d’indexation des pages) si certaines sont déjà indexées.
- Ajoutez un noindex sur ces pages, via votre extension SEO ou le thème.
- Attendez qu’elles disparaissent de l’index, puis ajoutez la règle Disallow correspondante dans le robots.txt.
- Assurez-vous que les termes recherchés sont correctement échappés à l’affichage, pour éviter toute injection de contenu.
Shopify bloque déjà le répertoire de recherche dans son robots.txt par défaut. Sur WordPress, PrestaShop ou Magento, le réglage dépend du thème et des extensions installées : je le vois régulièrement mal configuré. C’est d’ailleurs un des points de ma checklist SEO.
Le cas des pages de recherche utiles
Certains sites transforment des recherches fréquentes en vraies pages de catégorie, avec un titre, un texte et une URL propre. C’est une bonne pratique, à condition que ce soit une page choisie et travaillée, pas une URL de recherche brute laissée indexable.
Quelles erreurs voit-on le plus souvent en bloquant la recherche interne ?
Le principe paraît simple, mais l’application l’est beaucoup moins. Dans les audits que je réalise, les problèmes ne viennent presque jamais d’une absence totale de réglage. Ils viennent d’un réglage à moitié juste.
- Une règle Disallow trop large. Une ligne écrite pour le répertoire de recherche peut aussi bloquer des pages utiles dont l’URL commence de la même façon, par exemple une rubrique ou un guide qui contient le même mot. Je teste toujours la règle sur une liste d’URL importantes avant de la publier.
- Une règle trop étroite. Le site bloque le format principal, mais laisse passer une variante : la pagination des résultats, un paramètre de tri ajouté, une version avec un autre préfixe de langue. Les espaces infinis se reconstituent par la porte de côté.
- Des liens internes vers des pages de recherche. Des blocs « recherches populaires », des nuages de mots clés ou des liens de navigation construits sur des requêtes internes envoient Googlebot droit sur ces URL. Bloquer l’exploration ne suffit pas si le site les met lui-même en avant : je remplace ces liens par des liens vers de vraies catégories.
- Des URL de recherche dans le sitemap. Certains modules les ajoutent automatiquement. C’est un signal contradictoire que je retire systématiquement.
- Un noindex qui n’apparaît pas dans le code reçu par Google. Quand la page de résultats est générée côté navigateur, la balise peut manquer dans la version initiale. Je vérifie avec l’outil d’inspection d’URL plutôt qu’en lisant le code dans mon propre navigateur.
Dernier point, plus discret : bloquer la recherche interne pour Google ne doit pas faire perdre les données de recherche du site dans l’outil d’analyse. Ces requêtes internes sont une mine pour savoir ce que les visiteurs cherchent et ne trouvent pas. Je m’assure que leur suivi reste en place, puis je m’en sers pour décider quelles recherches fréquentes méritent une vraie page de catégorie.
Mon avis sur cette précision de Google
Je ne change rien à ma recommandation : les pages de recherche interne n’ont rien à faire dans l’index de Google. Le fait que la règle ait quitté la documentation ne la rend pas moins utile, et l’explication de John Mueller sur le spam la rend même plus urgente pour les sites qui l’ont négligée.
Sur les audits que je mène comme référenceur freelance, ce point fait partie des contrôles de base, avec les filtres à facettes et les paramètres d’URL, qui posent exactement le même problème d’espaces infinis. Si vous voulez un regard expert sur ces réglages, mon accompagnement de freelance SEO couvre l’exploration et l’indexation en détail, et vous pouvez découvrir ma démarche globale de référencement naturel.
Un doute sur des pages étranges indexées sur votre site, ou un message « piratage » dans la Search Console ? Écrivez-moi, on regarde ça ensemble.
FAQ : bloquer les pages de recherche interne
Google pénalise-t-il les sites dont les pages de recherche interne sont indexées ?
Non, Google ne les considère pas comme du spam en soi. Mais ces pages gaspillent l’exploration et peuvent être détournées pour afficher des termes indésirables, ce qui peut entraîner un signalement de piratage.
Faut-il utiliser noindex ou robots.txt pour la recherche interne ?
Les deux, dans cet ordre : d’abord le noindex pour sortir les pages déjà indexées, ensuite le Disallow dans le robots.txt pour arrêter l’exploration.
Comment savoir si mes pages de recherche interne sont indexées ?
Utilisez l’opérateur site: suivi du format de vos URL de recherche dans Google, et consultez le rapport d’indexation des pages dans la Search Console.